AI QA engineer je jeden titul pro dvě různé práce: testování AI systémů a testování běžného softwaru pomocí AI nástrojů. První ověřuje, jestli model, prompt nebo agent dává odpovědi dost dobré na to, aby šly ven; u druhé dělají část testovací práce AI nástroje.
Obě se inzerují jako „AI QA engineer“. Chtějí jiné dovednosti, sedí v jiných týmech a podle aktivních inzerátů platí hodně rozdílně. A pod příbuznými hledanými výrazy, třeba „AI tester“ nebo „AI test engineer“, se schovává ještě třetí věc, která QA prací vůbec není.
Kterou z těch dvou prací inzerát nabízí
Titul to prozradí málokdy. Slovesa v popisu odpovědností ano.
Testování AI se v inzerátech pozná podle slov jako evaly, golden datasety, rubriky, LLM judge, red-teaming a regrese mezi verzemi modelu. Inzerát Glean na evals engineera popisuje systémy, které rozhodují, jestli jsou nové modely, prompty, retrieval strategie a agentní workflow připravené jít k firemním zákazníkům. Tyhle role se obvykle obsazují jako ML nebo infrastrukturní inženýři a plat tomu odpovídá: role pro evaluace v post-trainingu u Anthropicu uvádí 500 000 až 850 000 USD, tedy úplný horní konec trhu.
Testování s AI se pozná podle generování testů z požadavků, samoopravných skriptů, třídění padajících testů pomocí AI a asistentů pro kód. Inzerát DevRev na quality engineera chce „snížit závislost na ručním psaní testovacích případů“ a zkušenost s validací AI systémů uvádí jen mezi „nice to have“. Seniorní QA role v Perplexity za 140 000 až 160 000 USD chce, aby testeři malé bugy rovnou opravili sami přes nástroje jako Cursor nebo Claude Code.
Ani jedna z těch rodin není podvod. Problém začíná, když si inzerát půjčí slovník té první a platí jako za tu druhou, nebo když se připravuješ na jednu a pohovor máš na druhou.
Deterministické testy vs. evaly
Pokud přicházíš z klasického QA, druhá rodina ti bude povědomá. Ta první rozbije pár návyků, na které se nejspíš spoléháš:
| Deterministický test | Eval | |
|---|---|---|
| Kritérium úspěchu | Výstup se rovná očekávané hodnotě | Výstup překročí práh ve vlastnostech, které sis definoval (správnost, opora ve zdrojích, bezpečnost, tón) |
| Kdo zná správnou odpověď | Zadání, nebo vývojář | Na začátku často nikdo; nejdřív vzorek oštítkuje doménový expert |
| Stejný vstup dvakrát | Stejný výsledek | Může se lišit, takže vzorkuješ a díváš se na poměry |
| Regrese je | Test, který zčervenal | Skóre, které na pevném datasetu kleslo po změně modelu, promptu nebo retrievalu |
| Hodnocení ve velkém | Aserce v kódu | Kontroly v kódu, kde to jde, model jako soudce, kde ne, lidé na vzorku |
| Typické nástroje | Playwright, pytest, JUnit, CI | Eval frameworky, oštítkované datasety, tracing, prompty pro soudce |
Nejvíc bolí druhý řádek. Model v roli soudce je užitečný jen tehdy, když se shoduje s člověkem, který doméně rozumí, takže i soudce potřebuje vlastní test. Návod Hamela Husaina k LLM soudcům doporučuje oštítkovat sadu skutečných výstupů s doménovým expertem, měřit shodu soudce zvlášť u úspěchů a zvlášť u selhání a dát přednost binárnímu ano/ne před škálou 1 až 5, protože rozdíl mezi trojkou a čtyřkou se definuje těžko. Dokumentace Anthropicu k evaluacím míří stejným směrem z druhé strany: víc otázek s automatickým hodnocením obvykle porazí pár ručně hodnocených a hodnoticí model má být jiný než ten testovaný. V praxi tak velká část úvodní práce na skutečné AI QA pozici padne na štítkování a dohadování, co znamená „správně“, dřív než vznikne první test. Inzerát Firecrawlu na evals pozici píše, že samotnou metriku je potřeba „vymyslet“.
V Evropě má tahle práce i regulatorní důvod. Článek 15 AI Actu EU požaduje, aby vysoce rizikové AI systémy dosahovaly přiměřené úrovně přesnosti a odolnosti a své metriky přesnosti uváděly. Někdo ta čísla musí vyrobit a obhájit.
AI tester: skutečná QA role, nebo anotační brigáda?
Když do Googlu napíšeš „AI tester“, ukáže ti hlavně detektory textu psaného AI. Když hledáš práci AI testera, výsledky míchají QA inzeráty s něčím jiným: Google k tomu sám nabízí „Outlier AI“, „AI training jobs“, „What is an AI task reviewer job?“ nebo „Does AI task pay real money?“.
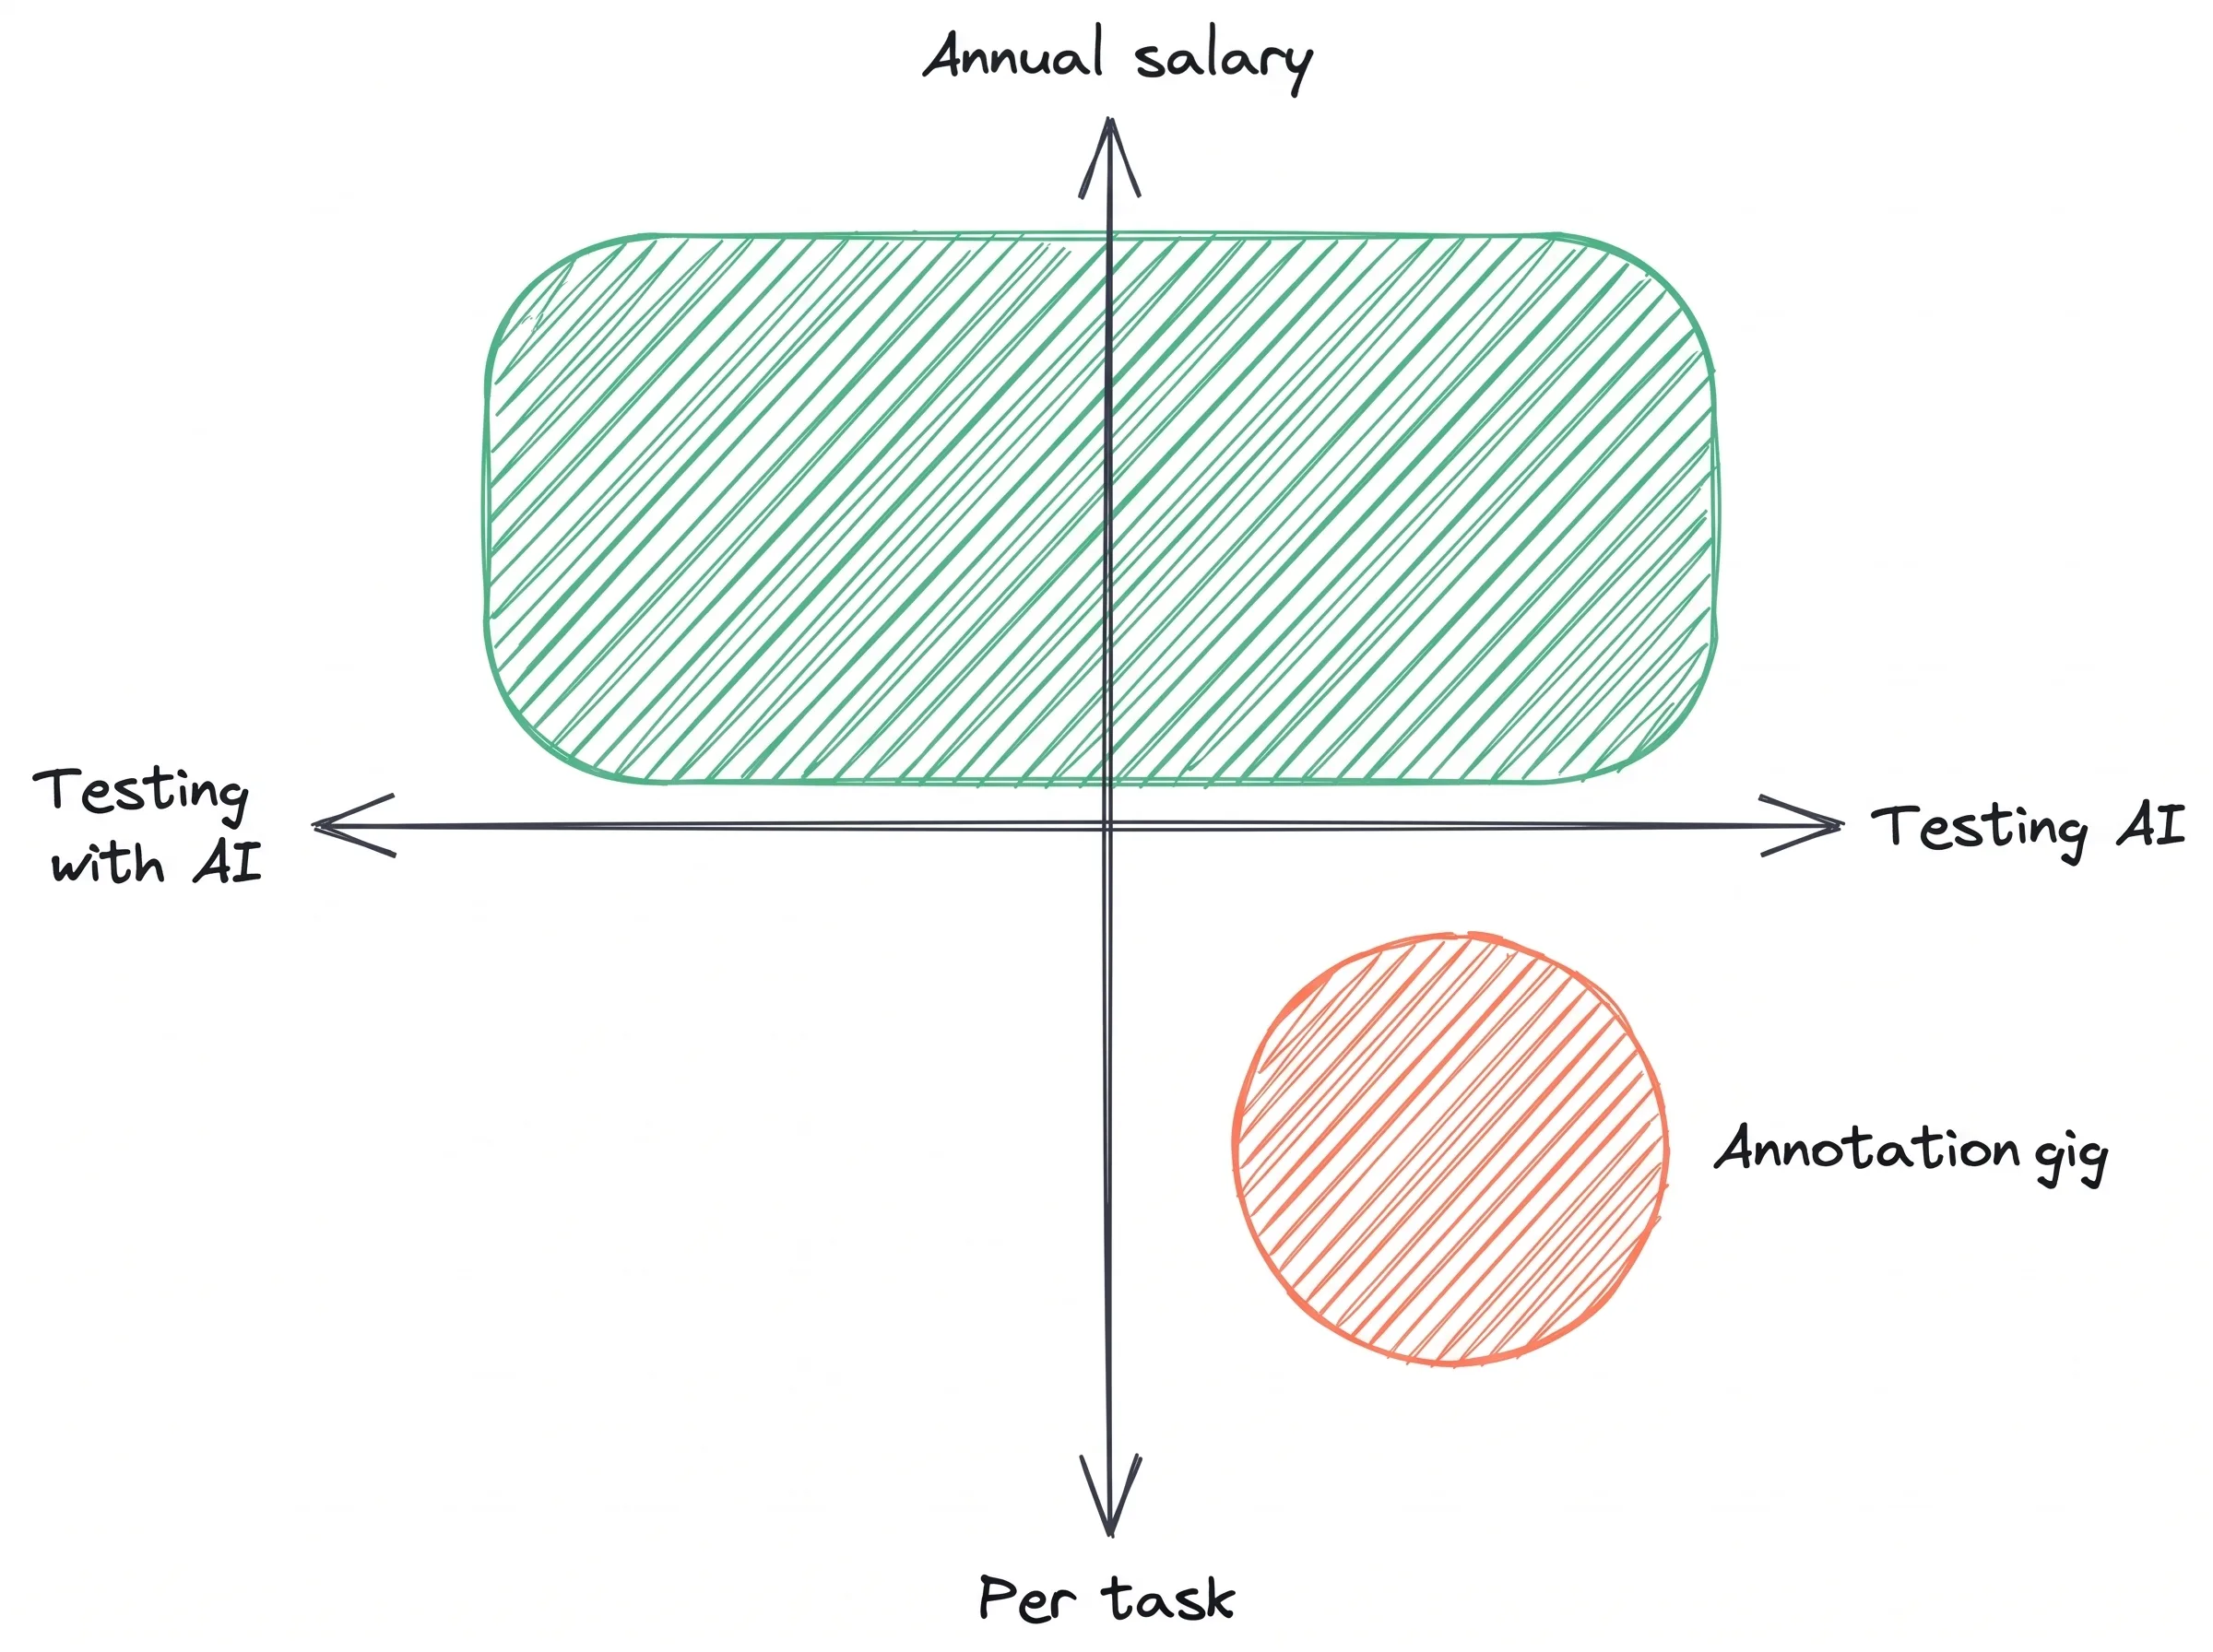
To něco jiného je anotace dat. Platformy jako DataAnnotation nebo Outlier platí kontraktory za hodnocení, opravy a psaní odpovědí modelů. Je to skutečná práce a část z ní se platí slušně: FAQ DataAnnotation uvádí u obecných úkolů od 25 do 50+ USD na hodinu a u kódu od 40 do 150+ USD. Podmínky jsou ale brigádnické. TIME psal o lidech, kteří prošli vstupním testem a pak nedostali žádný úkol, a o účtu, který platforma zablokovala s neproplacenou prací za 2 869 USD. Business Insider v reportáži o kontraktorech Scale AI citoval člověka, který za jediný měsíc strávil skoro 40 hodin neplaceným onboardingem a žádnou práci nedostal.
Jak ty dvě věci rozlišit dřív, než obětuješ večer vstupnímu testu:
| Signál | AI QA nebo evals role | Anotační brigáda |
|---|---|---|
| Zaměstnavatel | Konkrétní firma, na vlastní kariérní stránce nebo v ATS | Platforma; klient bývá anonymní |
| Jednotka platu | Roční plat, často s akciemi | Za hodinu nebo za úkol, často týdně |
| Výběrové řízení | Pohovory s týmem, do kterého půjdeš | Vstupní test, často neplacený |
| Co odevzdáváš | Eval sady, hodnoticí skripty, podklady pro rozhodnutí o releasu | Hodnocení a přepsané odpovědi podle cizí rubriky |
| Kontinuita | Pracovní smlouva a výpovědní lhůta | Projekty se otevírají a zavírají, přístup můžeš ztratit |
| Komu reportuješ | Engineering nebo AI leadovi | Frontě úkolů |
Pro kariéru anotace bezcenná není. Psaní rubrik a hodnocení výstupů modelu je základní dovednost, na které evaly stojí, a Harvey, firma vyvíjející AI pro právníky, nabírá na plný úvazek lidi, kteří řídí kvalitu lidských evaluací. Krok od jednoho k druhému znamená něco postavit, eval sadu nebo hodnoticí skript, a ukázat to.
Skutečné AI QA role nesou tišší riziko. Z deseti aktivních inzerátů na AI QA a evals pozice, které jsme pro tenhle článek prošli, nedával žádný roli výslovnou pravomoc zastavit release. Můžeš vlastnit „laťku kvality“ a přitom rozhodnutí jen podkládat. Na pohovoru se zeptej, kdo rozhoduje, když eval týden před spuštěním neprojde, a co se stalo naposledy.
Pokud zvažuješ přechod z klasického QA do evalů, nebo držíš dvě nabídky, kde obě říkají „AI“ a každá myslí něco jiného, vyplatí se to s někým probrat. Přesně s takovými kariérními otázkami pracuju v 1:1 kariérním mentoringu.